Una organización no necesita experimentar una vulneración para comprobar hasta qué punto depende de su infraestructura digital. Desde la facturación y la tesorería hasta los canales de atención y las bases de datos de clientes, una falla tecnológica puede paralizar la operación.
La ciberseguridad corporativa moderna trasciende el departamento técnico: exige un enfoque integral para prevenir, detectar, responder y recuperar, apalancando la inteligencia artificial (IA) como aliada estratégica en la gestión de riesgos.
1. La ciberseguridad como prioridad gerencial
Históricamente, la seguridad digital se ha delegado de forma exclusiva al área de tecnología. Sin embargo, un incidente crítico impacta directamente en la viabilidad del negocio:
- Detiene líneas de producción y despachos.
- Bloquea la emisión de facturas y el flujo de caja.
- Interrumpe la atención al cliente y deteriora la reputación corporativa.
- Expone información confidencial ante terceros.
Por ello, la ciberseguridad debe integrarse en la toma de decisiones directiva. Los líderes no requieren ser especialistas técnicos, sino desarrollar criterio para identificar dependencias, evaluar impactos operativos, formular las preguntas correctas y asignar responsabilidades claras.
2. Identificación de activos y dependencias críticas
El punto de partida consiste en clasificar los sistemas según su nivel de impacto operativo. Mientras la caída de una herramienta secundaria genera inconvenientes menores, la interrupción de la plataforma de facturación o cobros puede comprometer la liquidez inmediata.
Matriz de dependencias operativas
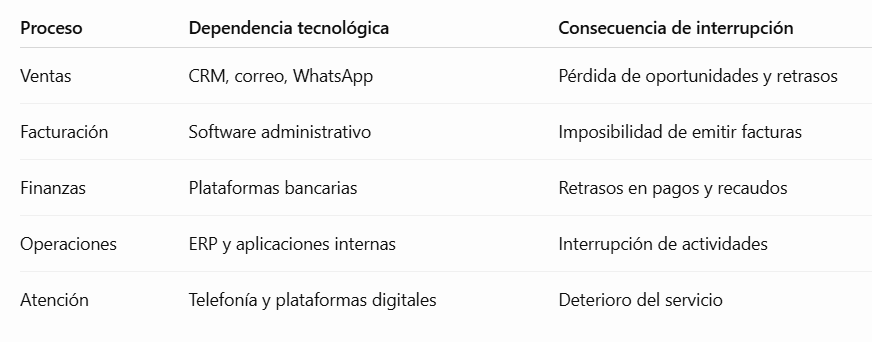
Para priorizar la protección, la gerencia debe evaluar cuatro variables: impacto económico, tiempo máximo tolerable de indisponibilidad, obligaciones contractuales o regulatorias y afectación a usuarios.
El rol de la IA en la fase de análisis
Un asistente de IA permite acelerar el diagnóstico al estructurar entrevistas con líderes de área, consolidar inventarios de software y detectar riesgos cruzados (por ejemplo, múltiples sistemas críticos alojados bajo un mismo proveedor).
Prompt sugerido para análisis de riesgos:
Actúa como asesor de continuidad del negocio. Analiza la lista de procesos, sistemas y proveedores que te proporcionaré a continuación. Construye una matriz de dependencias y riesgos, identificando procesos críticos, consecuencias operativas ante caídas y preguntas clave para establecer prioridades. No asumas tiempos de recuperación definitivos; señala los puntos exactos que cada líder de área debe validar.
3. Controles básicos de protección preventiva
La mayoría de los incidentes se mitigan implementando controles de higiene digital que no demandan inversiones desmedidas:
- Gestión estricta de accesos: Implementar el principio de privilegio mínimo (cada colaborador accede únicamente a lo indispensable para su rol). Auditar periódicamente credenciales administrativas y dar de baja cuentas inactivas.
- Autenticación multifactor (MFA): Habilitar un segundo factor de autenticación en todas las cuentas corporativas, priorizando accesos a correo, VPN y plataformas financieras.
- Actualizaciones y parches: Establecer calendarios periódicos para mitigar vulnerabilidades conocidas. Aquellos equipos obsoletos que no admitan soporte deben aislarse de la red principal o sustituirse.
- Copias de seguridad (backups): Mantener respaldos inmutables (protegidos contra borrado o cifrado por atacantes). Es imperativo programar pruebas periódicas de restauración real para garantizar su integridad.
- Cultura y formación del personal: Capacitar a los colaboradores en la detección de correos sospechosos (phishing), solicitudes atípicas de transferencias y suplantación de identidad. La IA puede generar casos de estudio y simulaciones controladas de ingeniería social.
4. Plan de Continuidad del Negocio (BCP)
El plan de continuidad prepara a la empresa para operar durante incidentes graves, ya sean ataques de ransomware, caídas de telecomunicaciones, cortes eléctricos o fallas de proveedores críticos.
[ Incidente ] │ ▼ ┌──────────────────┐ │ RPO (Tolerancia) │ ◄── ¿Cuántos datos podemos perder? (En tiempo) └──────────────────┘ │ ▼ ┌──────────────────┐ │ RTO (Objetivo) │ ◄── ¿Cuánto tiempo podemos tardar en volver a operar? └──────────────────┘ Todo plan de continuidad debe definir dos métricas fundamentales:
- RTO (Recovery Time Objective): Tiempo máximo admisible para restablecer un sistema o servicio tras una interrupción.
- RPO (Recovery Point Objective): Cantidad máxima de datos que la organización tolera perder, medida en tiempo transcurrido desde el último respaldo.
Ejemplo: Si una compañía define un RTO de 4 horas y un RPO de 1 hora para su sistema de ventas, significa que ante un desastre debe volver a facturar en menos de 4 horas asumiendo una pérdida máxima equivalente a los últimos 60 minutos de transacciones.
Aplicación de IA en la continuidad
La IA agiliza la formulación de escenarios hipotéticos de crisis (stress testing conceptual) y la estructuración de manuales de contingencia operativa manual. Sin embargo, los procedimientos deben someterse a pruebas empíricas; la validez de un plan se demuestra en la práctica, no en el documento.
5. Protocolo de respuesta ante incidentes
Basado en las recomendaciones del marco internacional NIST CSF 2.0, un protocolo estructurado reduce el margen de improvisación ante una brecha de seguridad.
[1. Detectar y reportar] ──► [2. Evaluar y clasificar] ──► [3. Contener] │ [6. Aprender] ◄── [5. Recuperar] ◄── [4. Investigar / Corregir]- Detectar y reportar: Identificar anomalías operativas, registrar la hora del evento, recopilar evidencia inicial y notificar a los responsables internos.
- Evaluar y clasificar: Determinar la tipología del ataque, identificar qué sistemas han sido comprometidos y estimar el impacto preliminar.
- Contener: Aplicar medidas urgentes para evitar la propagación (como desconectar segmentos de red o suspender credenciales) preservando la evidencia forense para auditorías posteriores.
- Investigar y corregir: Localizar la causa raíz, neutralizar los vectores de persistencia del atacante y solucionar la brecha original.
- Recuperar: Restaurar las operaciones sobre ambientes seguros y limpios, validando la integridad de los datos antes de reactivar los flujos productivos.
- Aprender: Realizar una sesión de lecciones aprendidas (post-mortem), actualizar protocolos y corregir vacíos normativos o técnicos.
6. Guía de actuación durante las primeras 24 horas
La respuesta inmediata define el costo total de un incidente de seguridad.
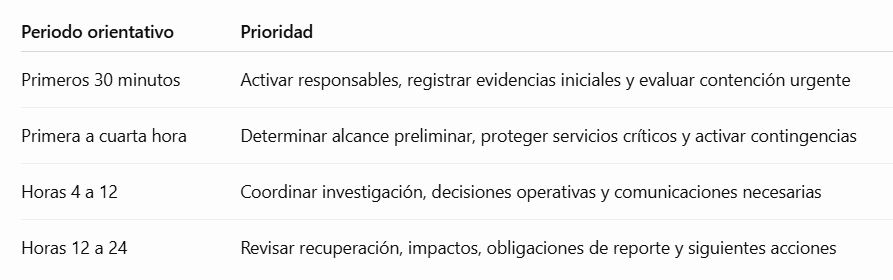
Nota regulatoria:En Colombia, las organizaciones afectadas pueden y deben apoyarse en los canales oficiales de COLCERT para la notificación técnica de incidentes y consulta de alertas de seguridad vigentes.
7. Usos y límites de la IA durante un incidente
La IA optimiza la gestión operativa bajo situaciones de alto estrés, actuando como un centro de procesamiento de datos:
- Consolida líneas de tiempo (timelines) basadas en registros de diversos equipos.
- Sintetiza bitácoras técnicas para preparar reportes ejecutivos o borradores para clientes.
- Cruza acciones en curso con las listas de verificación (checklists) del plan de respuesta.
Límites de seguridad en el uso de IA
La IA no debe ejecutar decisiones críticas de forma autónoma (como apagar servidores de misión crítica o publicar comunicados). Asimismo, nunca debe cargarse información confidencial, código fuente o datos personales en herramientas de IA abiertas que no garanticen acuerdos de privacidad empresarial.
8. Validación operativa mediante simulacros
La eficacia de una política de seguridad solo se comprueba bajo presión simulada.
Escenario de simulación gerencial:
Lunes, 9:00 a. m. El acceso al software de facturación y ERP se encuentra bloqueado. El proveedor de nube notifica que sufre una intrusión no autorizada y no ofrece fecha estimada de restablecimiento.
Frente a esta situación, el comité debe responder:
- ¿Quién está formalmente facultado para declarar la contingencia operativa?
- ¿Cuáles son las alternativas para continuar despachando y facturando manualmente?
- ¿Qué mensaje oficial se emitirá a clientes y proveedores clave?
- ¿Qué evidencias técnicas se exigirán al proveedor antes de restablecer conexiones?
La IA puede actuar como facilitadora del ejercicio, inyectando variables imprevistas durante la sesión y generando al final un informe preliminar de brechas operativas.
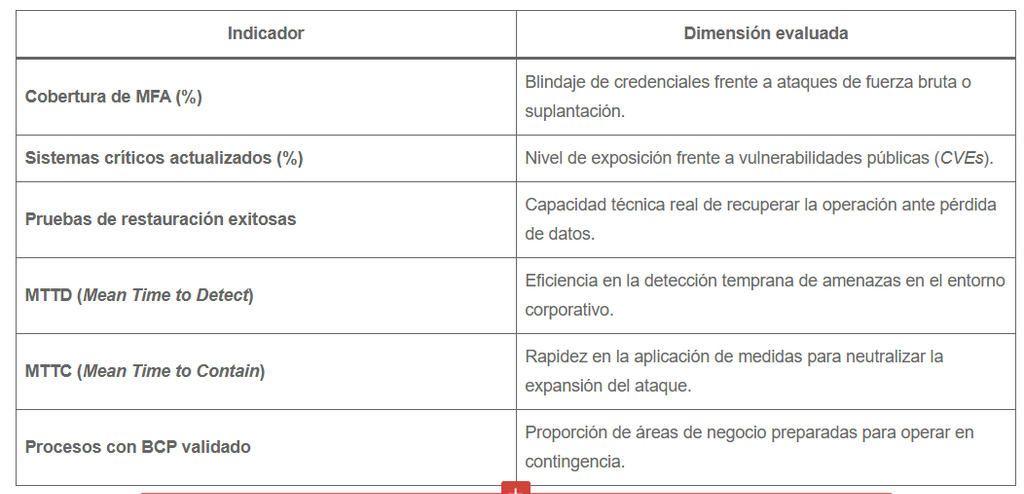
9. Métricas de gestión para la toma de decisiones
La ciberseguridad debe medirse con indicadores clave vinculados al riesgo de negocio:
10. Hoja de ruta de 30 días para fortalecer la empresa
SEMANA 1 SEMANA 2 SEMANA 3 SEMANA 4 [Diagnóstico] ──► [Protección] ──► [Continuidad] ──► [Simulación]- Semana 1 (Diagnóstico): Identificar procesos críticos, levantar inventario de sistemas y proveedores, y mapear controles actuales.
- Semana 2 (Protección): Desplegar MFA de manera obligatoria, auditar permisos administrativos y calendarizar parches críticos.
- Semana 3 (Continuidad y respuesta): Definir métricas RTO/RPO, redactar el protocolo de respuesta ante incidentes y asignar roles de crisis.
- Semana 4 (Simulación y mejora): Conducir un simulacro de mesa (tabletop exercise), evaluar decisiones y consolidar el plan correctivo.
Prompt sugerido para diagnóstico de 30 días:
Actúa como asesor de gestión de riesgos y continuidad de negocio. Con los datos autorizados que te compartiré, analiza procesos críticos, dependencias y controles existentes. Identifica vacíos operativos y elabora un plan estructurado a 30 días que detalle actividades semanales, roles sugeridos, evidencias de cumplimiento y nivel de criticidad. Diferencia hechos verificables de suposiciones y no inventes niveles de madurez técnica.
Puntos clave
- Responsabilidad directiva: La seguridad digital protege la continuidad de la facturación, el recaudo y la operación general de la empresa.
- Definición de RTO y RPO: Establecer con precisión cuánto tiempo puede estar caída la empresa y cuánta pérdida de datos puede absorber el negocio.
- Higiene técnica preventiva: La combinación de autenticación multifactor (MFA), parches al día, copias de seguridad aisladas y personal capacitado previene la mayoría de los incidentes.
- Protocolos probados: Un plan de respuesta a incidentes debe basarse en marcos reconocidos (como NIST) y validarse mediante simulacros regulares.
- IA con gobierno claro: La inteligencia artificial actúa como un catalizador para ordenar información y acelerar diagnósticos, pero las decisiones críticas deben permanecer bajo supervisión humana calificada.
Fuentes y Referencias
- COLCERT. (s. f.). Reportar un incidente. colcert.gov.co
- Fisher, W., Souppaya, M., Barker, W., & Kent, K. (2026). Ransomware risk management: A Cybersecurity Framework 2.0 community profile. NIST IR 8374r1. https://doi.org/10.6028/NIST.IR.8374r1
- National Institute of Standards and Technology. (2025). Incident response recommendations and considerations for cybersecurity risk management: A CSF 2.0 community profile (SP 800-61 Rev. 3).
- National Institute of Standards and Technology. (2026). Cybersecurity, enterprise risk management, and workforce management quick-start guide. NIST SP 1308. https://doi.org/10.6028/NIST.SP.1308
- Pascoe, C., Quinn, S., & Scarfone, K. (2024). The NIST Cybersecurity Framework (CSF) 2.0. NIST CSWP 29. https://doi.org/10.6028/NIST.CSWP.29
Edición: Equipo editorial de IMKGlobal, con apoyo de herramientas de inteligencia artificial.
Somos Embajadores ZAPIA, conoce más en zapia.com/p/juliancastiblanco
ADOPTA IA + CEO AI BUILDER LAB
Menos operación. Más capacidad. Más dirección.
Si necesita crear o mejorar su sistema de gestión de Innovación e IA puede contar con nosotros.
Edición: Equipo editorial de IMKGlobal, con apoyo de herramientas de inteligencia artificial.
👉 Mira el catálogo de soluciones y mentoría de IMKGlobal AQUI
Soluciones digitales completas
Julian Andrés Castiblanco Herrera
🟢 CEO – Chief Executive Officer
ImkGlobal – Ingenieros de Marketing
✉ ceo@imk.global
📞 CO: +57 300 639 8181
Camilo Fernando Castiblanco
Dirección de Crecimiento para Proyectos Industriales /
Dirección de Ecosistemas de Innovación
growth@imk.global
Colombia+ 57 313 387 3446
United States: + 1 (689) 236 9820
www.imk.global
Visita nuestro Portal de https://experienciasimk.com/ia/